
过去几年,机器人操控模型的演进速度很快:从针对单一任务训练的模仿学习策略,到能够理解自然语言、处理多种物体并跨任务迁移的视觉—语言—动作模型(VLA),再到尝试用世界模型预测未来状态与动作的 WAM。模型越来越“大”,演示视频也越来越惊艳,但一个基础问题始终没有被很好解决:这些模型到底谁更强,强在哪里,又能否在真实机器人上稳定复现?
RoboDojo 的目标,就是为这个问题提供一套更接近“统一考试”的答案。
严格来说,RoboDojo 不是一种新的机器人控制算法,而是一套面向通用机器人操控策略的基准、基础设施和评测治理机制。它把大规模仿真测试、标准化真机测试、统一策略接口、远程评测和公开榜单连接在一起,希望把机器人模型的比较从“各自在自己的实验室、自己的机器人和自己的任务上报一个数字”,推进到尽可能一致、可复现、可审查的评测流程。
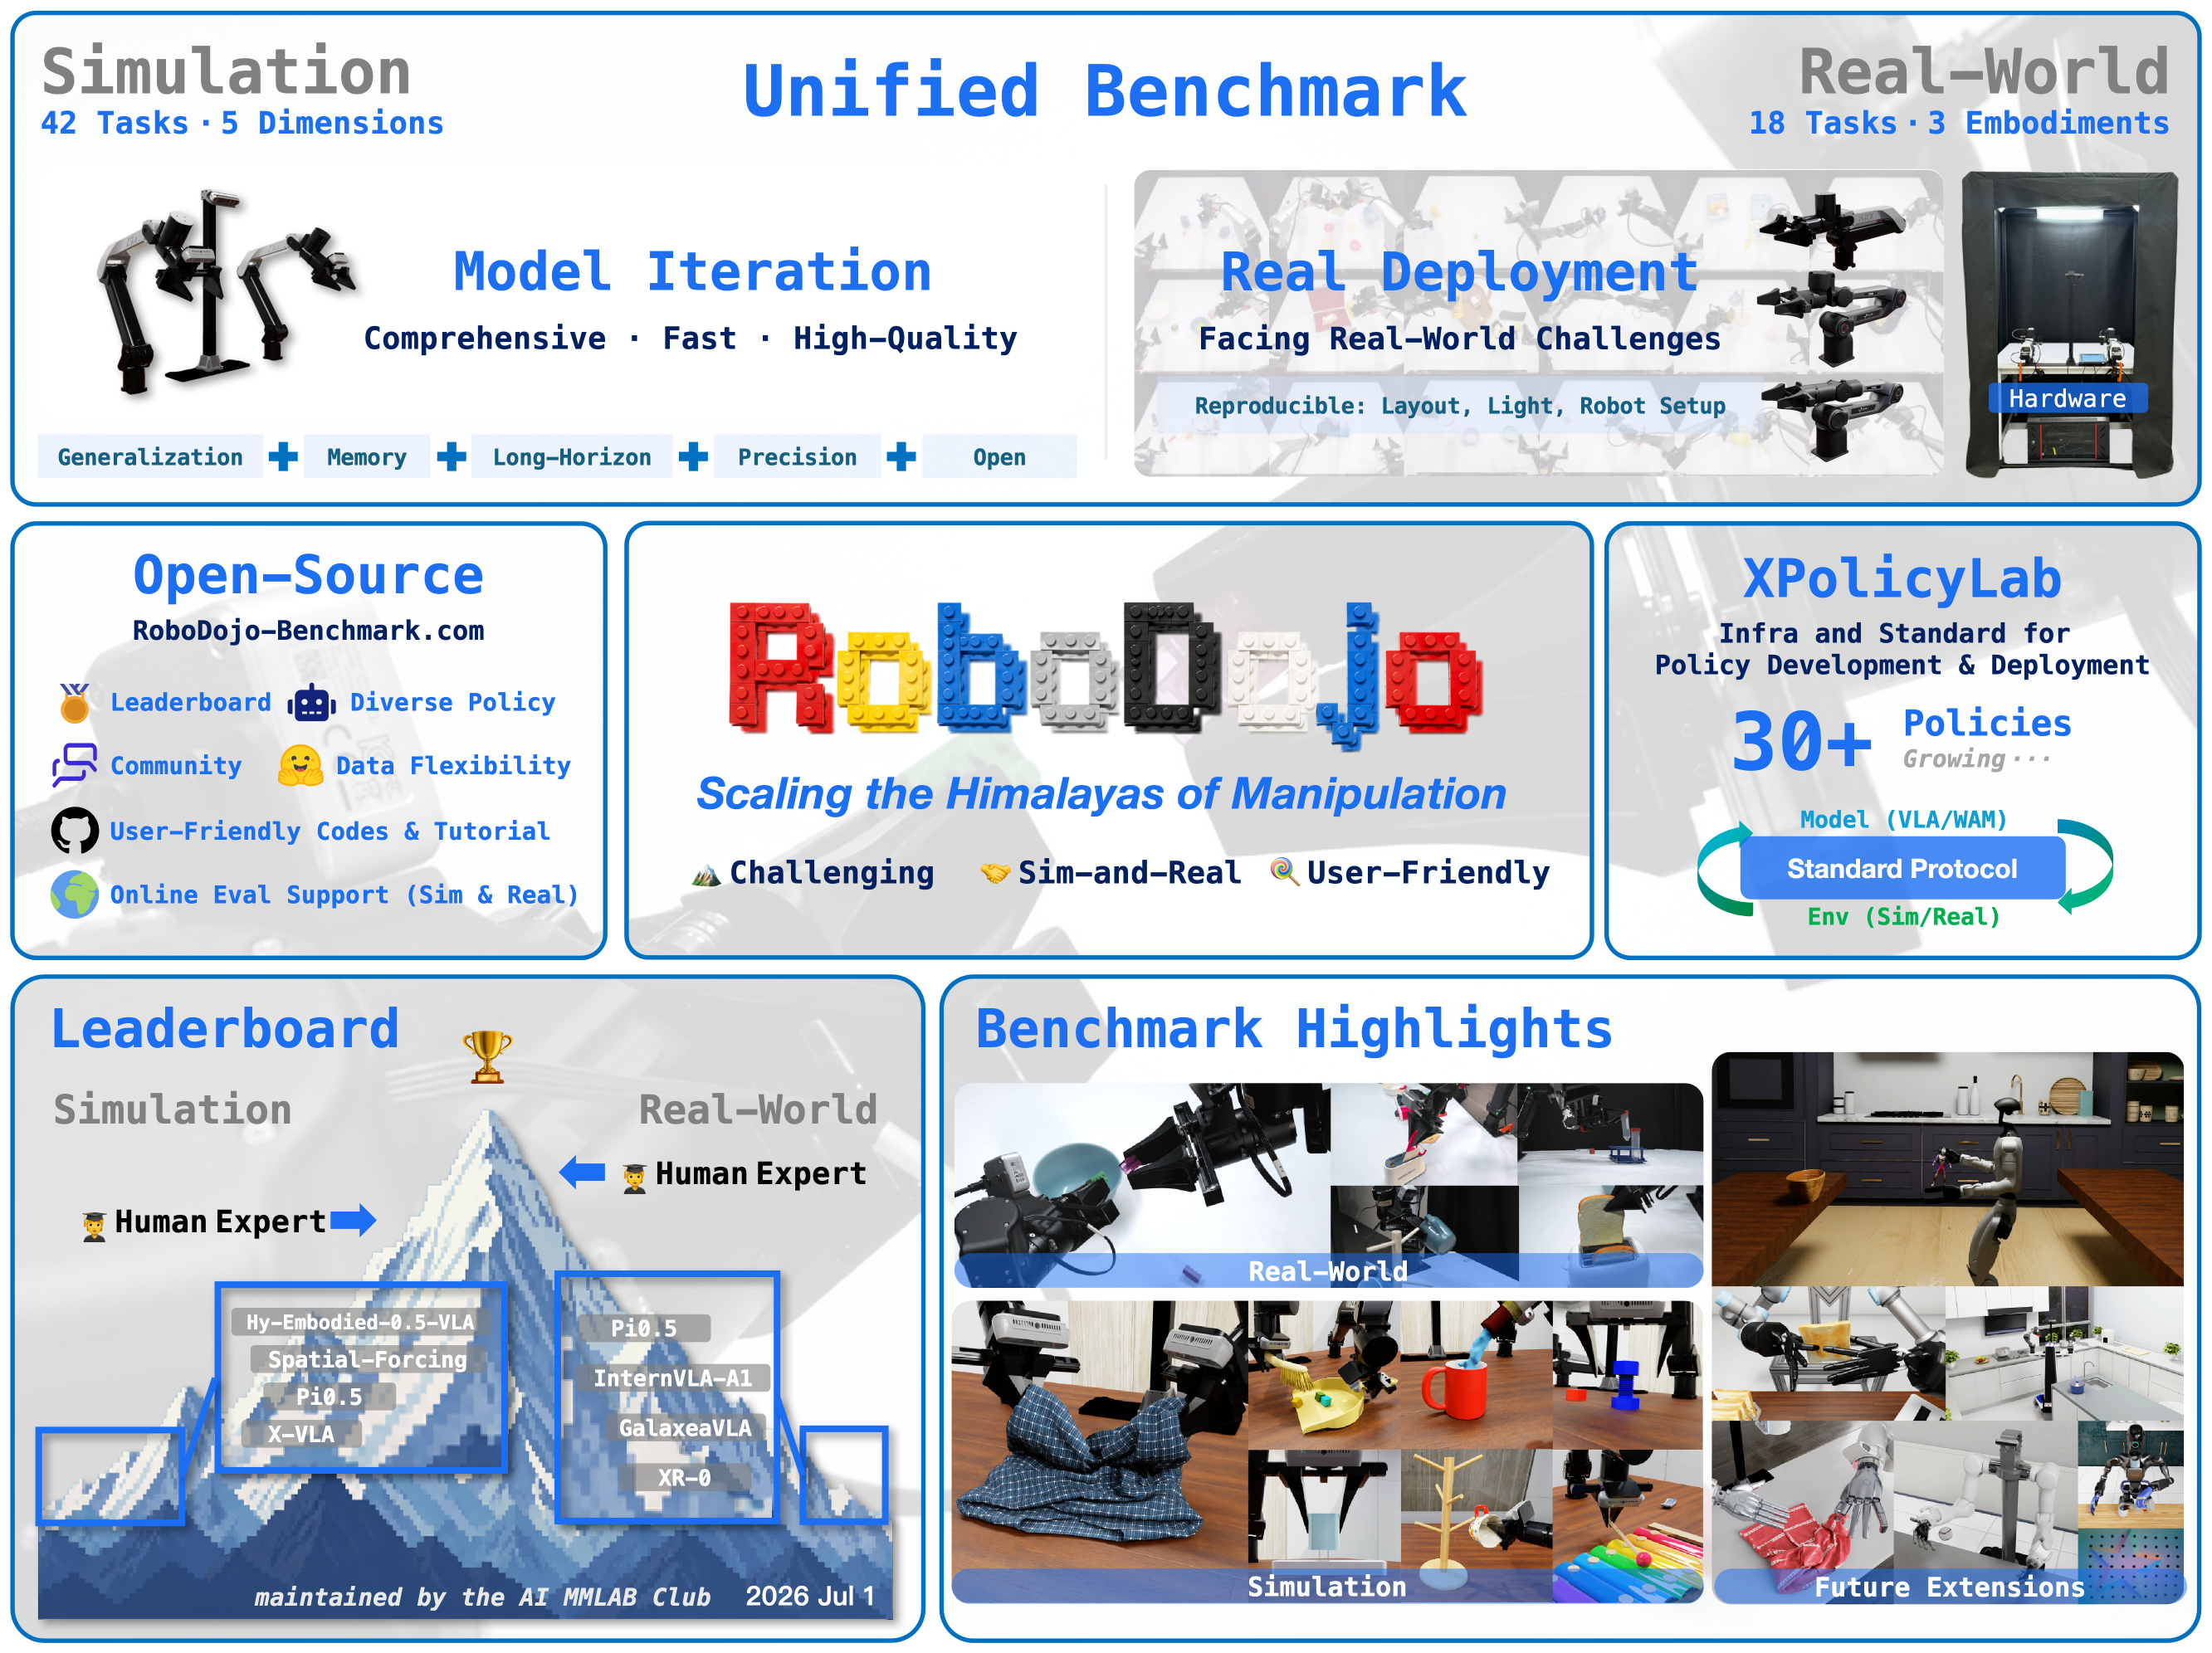
图 1:RoboDojo 官方总览图。上半部分连接 42 个仿真任务与 18 个真机任务,下半部分展示开源生态、XPolicyLab、榜单和任务样例。来源:RoboDojo 官方网站。
一句话理解 RoboDojo
可以把 RoboDojo 看成由四层组成的机器人策略“考场”:
- 试卷:42 个仿真任务和 18 个真实世界任务;
- 考场:基于 Isaac Sim 的并行仿真平台,以及标准化的 RoboDojo-RealEval 真机平台;
- 统一答题接口:XPolicyLab 把不同模型的数据格式、运行环境和动作接口适配到同一套协议;
- 监考与成绩单:官方远程评测、隐藏布局验证、视频公开、开源复现要求和持续更新的排行榜。
这四层缺一不可。只有任务而没有统一接口,接入成本会很高;只有仿真而没有真机,难以暴露接触、噪声和安全问题;只有公开榜单而没有验证协议,又容易出现针对测试集调参甚至“刷榜”。
RoboDojo 具体做了什么?
1. 用 42 个仿真任务诊断五类能力
RoboDojo 的仿真部分基于 NVIDIA Isaac Sim 和 Isaac Lab,采用 ARX X5 双臂平台。42 个任务不是简单地更换物体颜色或桌面背景,而是按五种能力组织:

图 2:RoboDojo 全部测试任务的官方总览。仿真任务按五个能力维度排列,底部为三种机器人本体上的 18 个真机任务。来源:RoboDojo 论文图 2。
| 能力维度 | 任务数 | 主要考察内容 |
|---|---|---|
| Generalization(泛化) | 12 | 面对新背景、光照、杂物和目标物体时是否仍能完成任务 |
| Memory(记忆) | 6 | 当前画面不包含全部信息时,能否利用此前观察做决策 |
| Long-Horizon(长程) | 8 | 能否维持任务进度、组合多个子技能并完成多步骤流程 |
| Precision(精密操作) | 8 | 定位、轨迹平滑度、插接和接触控制是否足够准确 |
| Open(开放指令) | 8 | 面对训练中没有直接出现的任务描述,能否重组已有技能 |
Generalization:同一个任务,换一个世界还能不能做
12 个泛化任务是:stack_bowls、push_T、pack_objects_into_box、fold_clothes、hang_mugs、sweep_blocks、pour_liquid_into_cup、make_toast、arrange_largest_number、sort_nesting_dolls_by_size、store_laptop_and_headphones 和 stack_blocks。
它们覆盖堆叠、推动、折叠、悬挂、清扫、倾倒、排序和收纳等操作。评测的重点不是模型能否背下木纹桌面的固定布局,而是任务结构不变时,面对新背景、光照、目标物体与最多 25 个干扰物是否仍能工作。每个任务的 50 次评测被拆成 25 次标准场景和 25 次随机场景。
几个任务能说明这种难度来自哪里:
sweep_blocks要先拿起扫帚并交接到右手,再由左手拿簸箕,最后把积木扫入簸箕,视觉泛化和双臂协同必须同时成立;pack_objects_into_box不只要求把多个物体放进箱子,还要求所有物体正面朝左,位置成功并不等于姿态正确;arrange_largest_number要识别四张数字牌并推理出能组成的最大数字,再按顺序放到垫子上;store_laptop_and_headphones要挂好耳机、合上随机开合角度大于 30° 的笔记本,再把笔记本插入竖直支架。
Memory:答案藏在过去的画面里
6 个记忆任务是:cover_blocks、match_and_pick_from_conveyor、swap_T、press_by_number、imitate_sorting_sequence 和 swap_blocks。
这些任务刻意让当前观测不足以决定下一步动作。例如,cover_blocks 中,机器人先从左到右盖住随机排列的红、绿、蓝积木,随后必须凭记忆按红—绿—蓝顺序揭开;match_and_pick_from_conveyor 中,第一个物体会随传送带消失,机器人要等待并抓取稍后出现的同类物体;press_by_number 则要求先读两张数字卡,再分别按对应次数按下红色按钮,最后按蓝色按钮确认——一旦提前确认,任务立即结束。

图 3:imitate_sorting_sequence 任务。机器人先观察对侧机械臂把五类物体按某一顺序放入篮子,再用自己一侧的对应物体复现顺序。来源:RoboDojo 论文 Appendix I。
Long-Horizon:单个技能会做,还要把十几步串起来
8 个长程任务是:put_bottles_into_dustbin、play_tic_tac_toe、classify_objects、fill_pen_holder、fill_egg_holder、organize_table、play_stacking_toy 和 make_kong。
这组任务重点测试阶段切换、任务进度维护、双臂交接和误差累积。例如:
organize_table要依次放置鼠标、收好键盘、摆放公仔和闹钟、打开抽屉,再把剩余杂物全部放进去;put_bottles_into_dustbin的四个瓶子可能站立或躺倒,右侧瓶子还需要在双臂之间交接才能越过偏置工作区投入垃圾桶;play_stacking_toy要把数量分别为 4、3、2、1 的四类套环全部放到匹配立柱上;make_kong要观察对手打出的麻将牌,在己方牌中找出匹配组合并完成“杠”的动作。
这类任务允许模型拿到不低的部分进度分,却仍可能因为最后一两个步骤失败而得不到成功判定。因此,Score 与 Success Rate 的差距在这里特别有解释力。
Precision:毫米级误差会直接变成失败
8 个精密任务是:fasten_screws、insert_tubes、plug_in_charger、pour_balls_into_vase、play_Xylophone、deposit_coin、insert_key 和 build_tower。
它们共同要求精确视觉定位、姿态调整、平滑轨迹和稳定接触。fasten_screws 要从五种颜色中匹配当次出现的三组螺钉与螺母,插入后还要旋紧;insert_key 要先拿起钥匙,交给另一只手调整姿态,再插入锁孔并转动;deposit_coin 要把硬币准确送入储蓄罐槽口;play_Xylophone 则要求持槌从左到右逐键敲击。模型即使理解了任务语义,只要末端轨迹抖动、接触角度不对或缺少偏离轨迹后的修正,仍会失败。
Open:没有任务演示,只能重组已有技能
8 个开放任务是:align_blocks、solve_equation、stack_blocks_by_language、general_pickup、classify_objects_by_language、pick_from_conveyor_by_image、store_tools_in_toolbox 和 pour_by_language。
Open 维度完全不提供任务级训练演示。策略只能利用其他任务学到的抓取、推动、分类、堆叠和倾倒技能,再根据新语言或图像提示组合动作。比如 solve_equation 要从随机摆放的数字和运算符中找出缺项,完成桌面上的算式;pick_from_conveyor_by_image 要先把篮子抬高 8 厘米以上,再根据展示板上的图片识别传送带目标并放入篮子;align_blocks 则要求把直角尺当作工具,把三块积木推成一条对齐直线。
此外,训练集还有一个不计入 42 个评测任务的 DLC 辅助目录:机器人要在复杂背景和拥挤桌面上找出字母,依次拼出“RoboDojo”。这 100 条域随机化轨迹只用于增加视觉暴露,不包含任何评测任务的解法。
一个 episode 到底怎样结束
仿真任务使用任务专属成功条件,并同时记录完整成功与子步骤进度。最大交互步数不是统一写死:官方先计算该任务演示轨迹长度的第 90 百分位,再乘以 1.2;对自动生成的短任务使用 1.5 倍,以免轻微轨迹变化导致过早终止。达到成功条件、发生任务规定的终止事件,或用完交互步数后,episode 结束。
配套训练集包含 35 个任务目录、3,500 条轨迹、约 186 万帧和 20.66 小时双臂数据。Open 维度不提供对应任务的训练演示,目的正是测试策略能否把已经学过的技能重新组合,而不是复现任务模板。评测时,每个仿真任务运行 50 个 episode,共 2,100 个 episode;官方榜单要求以三个随机种子报告均值和标准差。总成绩按五个能力维度等权平均,避免任务数量更多的维度主导最终排名。
2. 用 18 个真机任务检验“能不能落地”
仿真可以高效、可重复地暴露问题,但无法完整复制真实世界中的摩擦、接触、执行器误差、相机噪声和意外碰撞。为此,RoboDojo 又在 ARX X5、Piper 和 Piper X 三种双臂机器人上设计了 18 个真机任务,每种本体 6 个。
| 机器人本体 | 6 个测试任务 | 主要挑战 |
|---|---|---|
| ARX X5 | insert_tubes、make_bread、make_food、pack_and_pour_fruit、cover_blocks、store_in_safe |
精密插入、记忆、多物体收纳和长程厨房流程 |
| Piper X | disassemble_LEGO、cap_pen、hang_mugs、classify_objects、sweep_blocks、pack_objects_into_backpack |
接触拆解、双手对准、工具使用、分类与柔性容器收纳 |
| Piper | fill_pen_holder、put_objects_into_basket、stack_and_cover_blocks、stack_bowls、stand_up_bottles、insert_charger |
多物体抓放、堆叠稳定性、姿态恢复和连接器插接 |
真机任务不是简单的“抓起来再放下”。make_food 要先取出砧板,把牛排和刀放到砧板上,再把蔬菜与虾放进锅里,把锅移到炉灶并盖上锅盖;insert_charger 要先把充电插头插入插线板,再把充电线接到插头上;stack_and_cover_blocks 则要求先稳定堆叠积木,最后用杯子把整座积木盖住。每个动作都会改变后续状态,中间的抓取偏差、遮挡或碰撞很容易累积成最终失败。

图 4:ARX X5 上的 make_food 长程真机任务,需要完成砧板、食材、锅、炉灶和锅盖之间的一系列依赖步骤。来源:RoboDojo 论文 Appendix J。
真机数据集包含 1,800 条轨迹、约 161 万帧和 17.91 小时数据。每个任务由 4 名操作者采集 100 条演示,并记录头部相机、双腕相机、机器人状态和语言标注。正式评测中,每个任务运行 10 次,因此一个覆盖三种本体的完整策略评测需要 180 次真机试验。
论文中的做法是针对每一种机器人本体分别训练一个随机种子,再在对应本体上评测。因此,“覆盖三种本体”衡量的是多平台部署覆盖面,不能直接解读为同一个 checkpoint 能够零样本控制三种机器人。
这里有一个容易误解的地方:RoboDojo 并没有为仿真与真机设计一一对应的任务对,也不是专门测量某个策略的直接 sim-to-real 迁移率。 两部分是互补关系——仿真用于快速、细粒度地诊断能力,真机用于检验物理部署中的稳定性和鲁棒性。
真机任务的最大执行时长同样来自演示数据:取该任务轨迹长度的第 90 百分位,再乘以 1.5。步数用尽会自动终止;若策略撞击桌面、外框或自身,评测人员也可以安全停止。最终评分由三名不知道模型身份的评审独立完成,既看最终结果,也看中间子步骤,并过滤分歧过大的样本后取平均值。
3. RoboDojo-RealEval:把真机实验做成可复现的远程服务
真实机器人评测最大的难点,往往不是模型推理本身,而是“考场”不一致:机械臂和相机差几厘米、灯光不同、桌面摩擦不同、每次摆放物体的位置不同,都可能改变结果。
RoboDojo-RealEval 因此固定了机械臂、相机、灯光和操作台的相对位置,并用模块化结构复现实验装置。评测人员通过触屏界面完成场景重置、策略运行、急停、录像和云端评分。重置场景时,系统把预先采集的目标布局以半透明图层叠加在实时画面上,帮助操作员恢复一致的初始条件。
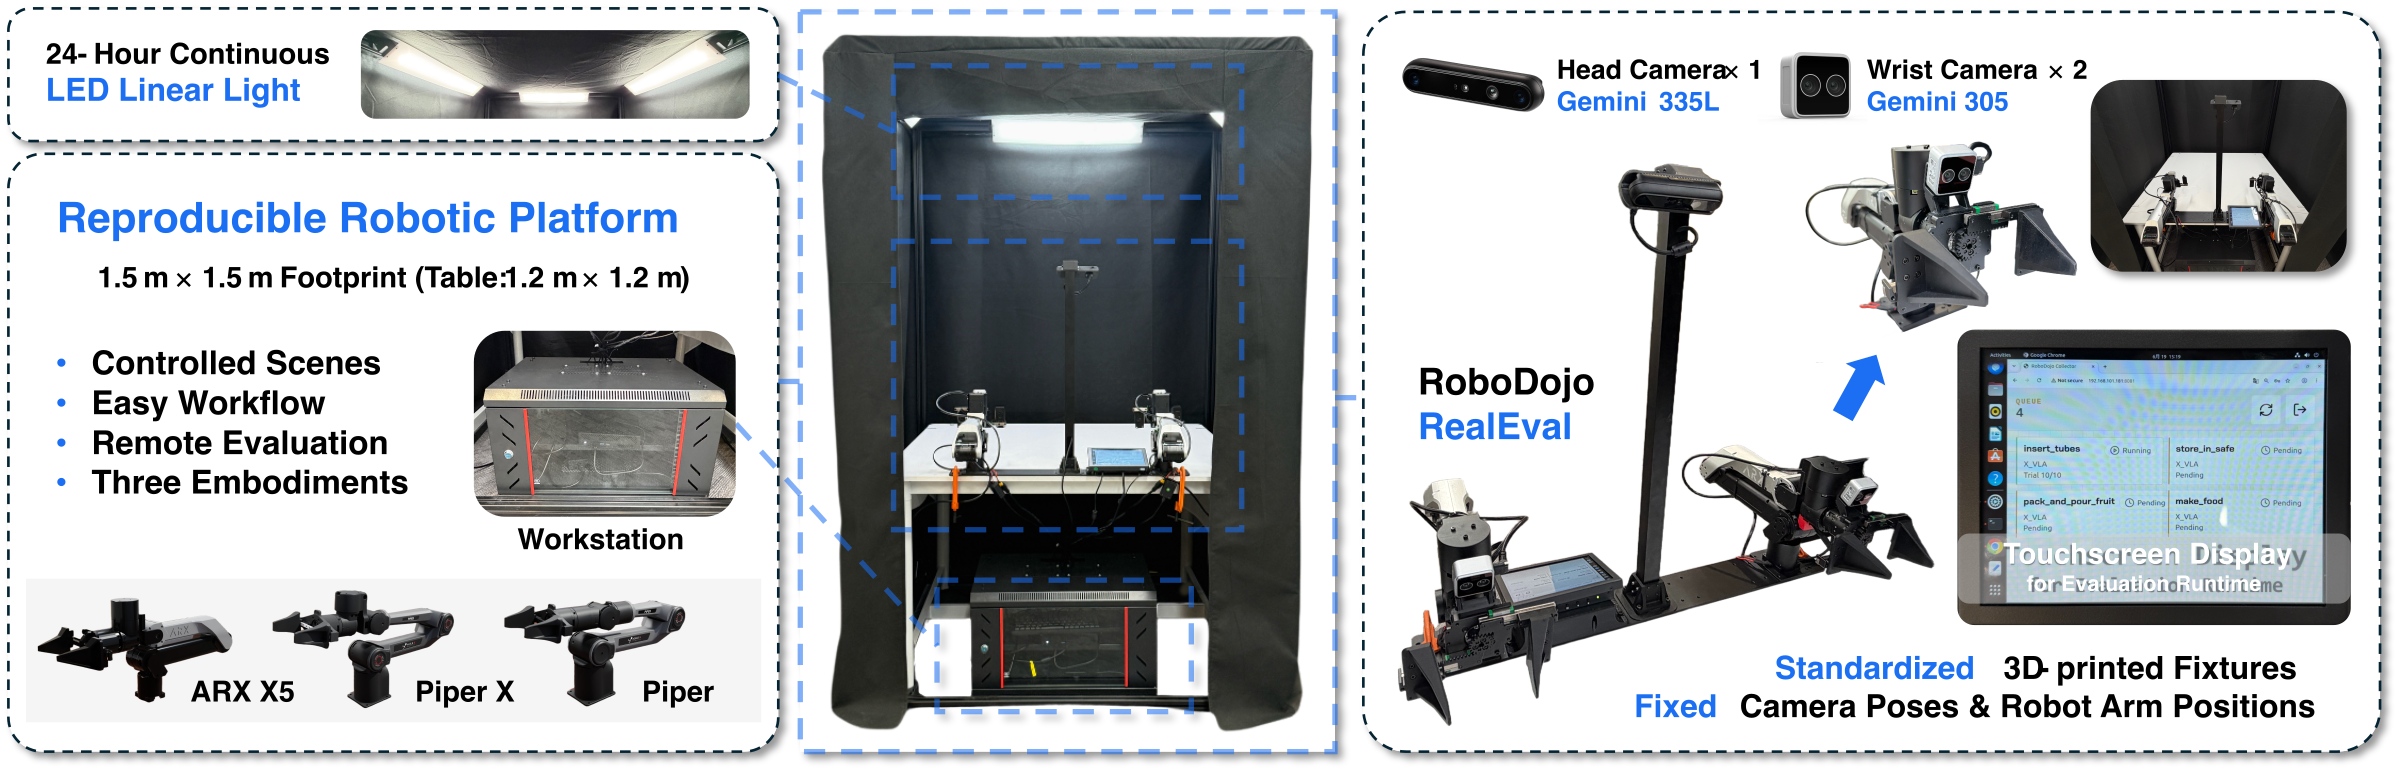
图 5:RoboDojo-RealEval 实物平台。1.2 米 × 1.2 米工作台位于 1.5 米 × 1.5 米 × 2.1 米外框内,配有固定 LED 光源、头部与腕部相机、三种可替换双臂本体、触屏和工作站。来源:RoboDojo 官方网站与论文 Appendix G。
每次真机试验都会录像,并由三名评审在双盲条件下独立评分。分数既考虑最终是否成功,也考虑中间子步骤的完成度,最终取三名评审的平均值。官方同时提供远程云端评测,让没有同款硬件的团队也能把策略接入统一真机平台。
4. XPolicyLab:一次接入,多处评测
机器人策略的工程栈高度碎片化:不同模型使用不同的数据格式、图像预处理、动作表示、依赖环境、训练脚本和部署方式。即使两篇论文都声称在同一个基准上测试,工程细节也可能让结果难以直接比较。
XPolicyLab 试图把这种 N 个策略对接 M 个环境的 O(N×M) 工作,压缩为“每个策略写一个适配器、每个环境写一个客户端”的 O(N+M) 结构。它统一了观测更新、动作预测、策略重置、批量查询、远程通信和部署流程,同时保留模型内部架构。
RoboDojo 论文最初通过 XPolicyLab 集成了 30 个代表性策略;截至 2026 年 10 月,XPolicyLab 官方仓库称生态已经覆盖 55 个策略,包括 VLA、世界—动作模型、模仿学习和记忆增强方法。对研究团队而言,这一层的价值不亚于任务本身:策略接入一次后,可以在 RoboDojo 仿真、标准化真机平台以及其他已接入基准上复用。
5. 异构并行仿真:不是把同一个场景复制几十份
传统向量化仿真通常复制同一种场景,只改变物体位姿或随机种子。RoboDojo 的“异构并行”允许不同并行环境拥有不同物体类别、几何形状、干扰物数量、关节结构和任务布局,在保留场景多样性的同时并行推进。

图 6:同时运行的异构仿真环境。不同格子不是同一场景的简单复制,而是具有不同任务、物体、背景、干扰物和布局。来源:RoboDojo 论文图 6。
论文报告,在 8 张 RTX 4090 上进行零动作 rollout 时,异构并行达到 77.4 interactions/s,非异构设置为 40.0 interactions/s,提升约 1.94 倍;加入 π0.5 推理后,吞吐量为 64.0 interactions/s,对比非异构设置的 39.2 interactions/s,提升约 1.63 倍。这里的数字取决于论文所用硬件和配置,不应被理解为所有部署环境都能获得相同加速,但它证明了多任务、大规模评测在工程上是可行的。
榜单怎么看:Score 和 Success Rate 不是一回事
RoboDojo 同时报告两个核心指标:
- Success Rate(SR):完整完成任务的 episode 比例,是严格的二值指标;
- Score:把中间子步骤的完成度也计入,因此能看出“做到一半”和“完全没有进展”的区别。
如果一个模型 Score 不低但 SR 很低,通常说明它能完成部分阶段,却无法把多个子技能稳定组合成最终成功。这在长程任务中尤其常见:一次小误差会沿着后续步骤持续累积。
当前仿真主榜 Top 10
以下为 RoboDojo 在线榜单 截至 2026 年 10 月 9 日(UTC+8) 显示的仿真主榜,按综合 Score 排名。官网将 Agent 类系统单列,因此表中不包含 Agent 赛道。
| 排名 | 模型 | Score | Success Rate |
|---|---|---|---|
| 1 | VPP2 | 39.26 | 32.26% |
| 2 | PhysicalRSI | 36.27 | 31.38% |
| 3 | Awomo-0.5 | 35.34 | 29.64% |
| 4 | Simate-beta | 33.95 | 27.96% |
| 5 | Rex-M1 Preview | 33.79 | 27.44% |
| 6 | VPP2-Preview | 31.40 | 25.62% |
| 7 | InternW0-Δ | 30.77 | 23.91% |
| 8 | Liber-0 Preview | 30.74 | 25.52% |
| 9 | Liber-0 Lite | 29.24 | 24.23% |
| 10 | DM0.5 | 24.90 | 19.34% |
这个榜单变化很快。论文在 2026 年 7 月 3 日冻结结果时,第一名还是 Hy-Embodied-0.5-VLA,Score 为 13.07、SR 为 8.80%;同一论文中的专家遥操作参考为 80.42 分、76.03% SR。三个月后,在线榜首已经提高到 39.26 分和 32.26% SR,说明基准发布后模型进展非常快;但若以论文中的人类参考作为粗略尺度,当前榜首仍有明显差距。由于这是跨时间快照比较,且官网包含 Preview 条目,它更适合展示趋势,不应被当作严格的纵向消融实验。
当前真机榜单 Top 5
| 排名 | 模型 | Score | Success Rate |
|---|---|---|---|
| 1 | OpenWAM-α | 37.6 | 24.4% |
| 2 | π0.5(官网记作 Pi-05) | 22.9 | 12.8% |
| 3 | InternVLA-A1 | 12.0 | 7.2% |
| 4 | GalaxeaVLA(G0) | 9.0 | 4.4% |
| 5 | Xiaomi-Robotics-0 | 7.9 | 3.9% |
真机榜和仿真总榜的顺序并不一致。例如 OpenWAM-α 在当前真机榜排名第一,但在仿真主榜并非第一;π0.5 也在真机上排名靠前。这并不等于“仿真无效”,而是再次说明两套任务承担不同角色,且并非一一对齐。要判断仿真分数能否预测真实部署,仍需要报告跨模型的秩相关性、匹配任务对照或更系统的 sim-to-real 分析。
评测协议:RoboDojo 为什么不只是一张排行榜
公开测试集一旦成为热门榜单,就会面临针对特定布局调参、人工挑选最好结果和训练数据泄漏等问题。RoboDojo 的官方协议采用几层约束:
- 成绩必须通过官方在线评测系统生成,而不是团队自行上报;
- 仿真结果需要三个随机种子,并报告均值与标准差;
- 真机结果必须覆盖 ARX X5、Piper 和 Piper X 三种本体;
- 除公开布局外,官方还会使用隐藏随机布局检查过拟合和人工调参;
- 正式进入可验证榜单时,需要通过 XPolicyLab 公开实际受测的 checkpoint、训练与部署代码、配置和复现说明;
- 评测视频公开,允许社区检查,并提供申诉机制。
这种设计在“便于参与”和“结果可验证”之间做了折中:团队可以在私有开发阶段通过远程策略服务器测试,而不立即公开权重;但要把成绩作为正式、可复现的榜单条目发布,就必须开放完整评测工件。
这个领域是怎样走到 RoboDojo 的?
机器人学习基准的发展,大致经历了从“更多任务”,到“更明确的能力维度”,再到“连接仿真与真实部署”的过程。
| 阶段 | 代表工作 | 推动了什么 |
|---|---|---|
| 2019—2020:规模化仿真任务 | RLBench、robosuite、Meta-World | 提供大量标准任务、可复用环境和自动生成演示,让算法可以在共同任务集上比较 |
| 2021—2022:语言与长程组合 | CALVIN | 把自然语言条件、连续控制和多步骤任务组合引入核心评测 |
| 2023:持续学习与知识迁移 | LIBERO | 用空间、物体、目标和长程任务套件分析声明性与程序性知识迁移 |
| 2024:用仿真近似评估真机策略 | SimplerEnv | 研究仿真排名与真实机器人表现的相关性,降低真机评测成本 |
| 2025:双臂与更强泛化 | RoboTwin 2.0 | 扩展双臂任务和结构化域随机化,强调跨场景泛化 |
| 2025—2026:能力专项与真机基准 | RMBench、RoboArena、RoboChallenge、ManipulationNet、EBench 等 | 分别强化记忆、元素级诊断、标准化真机技能和具身推理评估 |
| 2026:统一评测闭环 | RoboDojo | 把五维仿真诊断、三种本体真机验证、统一策略接口、远程评测和榜单治理放进同一体系 |
RoboDojo 的创新因此不只是“任务更多”。在论文的横向统计中,它覆盖 24 类操作技能、60 个仿真与真机任务,并集成 35 个以上基线;相比之下,RoboTwin 2.0 更集中于 50 个仿真双臂任务和泛化,CALVIN 更集中于语言条件长程任务,LIBERO 更集中于持续学习与知识迁移,SimplerEnv 的核心问题则是仿真评测能否关联真机表现。
这些基准不是简单的替代关系。研究记忆机制时,RMBench 的专项设计可能更敏锐;研究终身学习时,LIBERO 的任务序列与迁移协议更合适;研究配对的 sim-to-real 相关性时,SimplerEnv 更直接。RoboDojo 的优势是覆盖面和统一闭环,代价则是每个专项问题未必都能做到最深。
与主要现有基准横向比较
下图把几个经常与 RoboDojo 一起讨论的基准放到同一组能力轴上。这里使用四档定性标记,而没有直接画成数值雷达图:这些项目并未在同一套任务、机器人和评分协议上比赛,把“是否重点研究某个问题”换算成连续分数,会制造并不存在的精确性。图中的“核心”“较强”“涉及”和“非核心”表示研究范围与设计重点,不表示模型在该维度的实际性能高低。
| 基准 | 多任务覆盖 | 语言与长程 | 双臂与泛化 | 持续学习 | sim-real 关联 | 标准化真机 | 评测治理 |
|---|---|---|---|---|---|---|---|
| RoboDojo | 核心 | 核心 | 核心 | 涉及 | 较强 | 核心 | 核心 |
| CALVIN | 较强 | 核心 | 涉及 | 涉及 | 非核心 | 非核心 | 涉及 |
| LIBERO | 较强 | 较强 | 涉及 | 核心 | 非核心 | 非核心 | 涉及 |
| SimplerEnv | 涉及 | 涉及 | 涉及 | 非核心 | 核心 | 涉及 | 涉及 |
| RoboTwin 2.0 | 核心 | 较强 | 核心 | 涉及 | 涉及 | 非核心 | 涉及 |
| RoboArena | 较强 | 涉及 | 涉及 | 非核心 | 涉及 | 核心 | 较强 |
核心 · 较强 · 涉及 · 非核心(不代表能力缺失)
图 7:六个机器人操控基准的能力侧重点。RoboDojo 的差异化优势是覆盖面和评测闭环;CALVIN 集中于语言条件下的长程组合;LIBERO 集中于持续学习与知识迁移;SimplerEnv 直接研究仿真排名与真机表现的关系;RoboTwin 2.0 强调双臂任务、规模和场景泛化;RoboArena 强调跨机构的分布式真机双盲评测。本图是依据各项目论文和官方协议所做的编辑性归纳,不是这些项目发布的统一量化评分。
从图中可以更直观地看到,RoboDojo 并非在每个单项问题上都最深入:持续学习仍是 LIBERO 的核心,配对式 sim-to-real 校准仍是 SimplerEnv 更直接,跨机构真实环境多样性则是 RoboArena 的优势。RoboDojo 更像把多任务诊断、双臂泛化、标准化真机平台、远程执行和榜单治理连成一条完整评测链路。
| 基准 | 最擅长回答的问题 | RoboDojo 的差异 |
|---|---|---|
| CALVIN | 策略能否根据语言连续组合多个技能? | RoboDojo 的诊断轴更多,并加入双臂真机评测,但 CALVIN 对语言条件长程组合更聚焦 |
| LIBERO | 模型能否在持续学习中迁移声明性与程序性知识? | RoboDojo 评测的是系统级综合操控能力,不以任务序列中的终身学习为核心 |
| SimplerEnv | 仿真表现能否预测真实机器人表现? | SimplerEnv 使用配对 sim-real 设计;RoboDojo 的两部分互补但不配对 |
| RoboTwin 2.0 | 双臂策略能否在强域随机化下泛化? | RoboDojo 增加五维能力诊断、异构并行、统一真机平台和榜单治理 |
| RoboArena | 在多机构、多环境中做双盲真机 A/B 测试会怎样? | RoboArena 用分布式多样性换覆盖面;RoboDojo 用集中式固定装置换可重复性 |
| RoboChallenge | 如何用机器人集群做大规模远程真机评测? | 两者都有远程真机评测,RoboDojo 更强调仿真诊断、三种双臂本体和统一开源工件 |
| RMBench | 策略究竟能否利用历史观察完成记忆依赖任务? | RMBench 的记忆诊断更专门;RoboDojo 把记忆放在五个互补维度中统一比较 |
从榜单看不同策略路线
RoboDojo 同时纳入单任务模仿学习、通用 VLA、世界—动作模型、记忆增强模型和 Agent 类系统。首版论文里,ACT、SmolVLA 等单任务或较轻量基线在综合榜上较低,而具有更强预训练、空间表征或时序建模能力的 Hy-Embodied-0.5-VLA、Spatial Forcing、π0.5 和 X-VLA 形成领先组。不同方法的强项也不相同:X-VLA 在首版 Precision 维度领先,Spatial Forcing 的泛化较强,Hy-Embodied-0.5-VLA 则在长程、记忆和综合成绩上领先。
当前在线榜单又出现了一批显著高于首版结果的新系统。这说明大规模预训练、更强动作先验、世界建模、推理式 Agent 或更有针对性的训练配方都可能推动成绩,但仅凭排行榜不能证明某种架构是因果上的最佳方案。不同条目可能使用不同规模的数据、算力、预训练模型和调参预算;Preview 模型的信息披露程度也可能有限。更可靠的结论仍需要统一数据预算、统一训练步数和多随机种子的控制实验。
RoboDojo 的主要优点
1. 把“会不会”拆成“哪里不会”
一个综合成功率无法区分模型究竟败在识别、记忆、精密控制还是多步规划。五维能力榜和任务级分数使失败更容易定位,也能防止某个模型靠少数熟悉任务掩盖短板。
2. 仿真效率与真机可信度兼顾
仿真用于快速迭代,真机用于暴露接触、噪声、动作不稳定和安全风险。两者共享策略接口和评测流程,减少了从离线实验到物理部署之间的工程断层。
3. 真机评测更接近“标准实验仪器”
固定硬件几何、灯光和场景重置流程,再加上远程接入,使真实世界结果更容易跨时间、跨团队比较。对于买不起三套双臂机器人的研究团队,这一点尤其重要。
4. 难度足够高,暂时没有饱和
首版最好模型只有 8.80% 的仿真成功率,数月后的在线榜首也只有 32.26%。低分本身不是基准优秀的充分条件,但结合专家遥操作的高成功率,至少说明任务并非不可完成,而是现有策略仍有大量能力缺口。
5. 把排行榜治理写进技术方案
隐藏布局、官方远程执行、三随机种子、完整工件开源和视频审查,明显提高了刷榜成本。相比只发布任务代码然后接受自报成绩,RoboDojo 更接近一个持续运营的公共评测服务。
仍有哪些局限?
1. “统一仿真与真机”不等于验证了 sim-to-real
由于仿真与真机没有配对任务,RoboDojo 目前更像两个共享接口的互补考场,而不是严格的迁移实验。下一步可以增加一组小规模的配对任务,报告不同模型在仿真与真机上的秩相关性、失败模式重合度和校准误差。
2. 本体和场景覆盖仍然有限
仿真只使用 ARX X5,真机覆盖三种协作式双臂平台,任务主要发生在结构化桌面环境。移动操作、灵巧手、全身人形控制、户外环境和人与机器人协作仍不在核心覆盖范围。未来若扩展本体,最好同时保持原有任务和指标稳定,避免榜单失去纵向可比性。
3. 真机统计量仍偏小
每个任务 10 次试验、每个本体一个训练随机种子,在机器人领域已经成本不低,但对失败率差距较小的模型仍可能不够。排行榜应进一步展示置信区间、评分者一致性和显著性检验,而不只是一个小数点后的排序。
4. 综合分数会压缩重要差异
五个维度等权平均比按任务数平均更合理,但仍隐含了“这五种能力同等重要”的价值判断。对于真实部署,安全停机、动作平滑度、接触力、恢复能力和完成时间可能比多获得几分更关键。论文也观察到某些策略会产生不稳定动作,需要人工安全干预;这些现象应该成为正式指标,而不只是定性分析。
5. 公开基准仍会产生适应性过拟合
隐藏布局可以防止最直接的布局记忆,却不能完全阻止团队围绕已知任务分布持续调参。长期运行时,RoboDojo 需要版本化任务集、保留真正未见的测试池,并明确何种差异算“显著偏离”公开布局成绩。
6. 接入门槛和资源成本仍然较高
高保真 Isaac Sim、多摄像头输入、大模型推理和多 GPU 评测对算力、驱动和工程环境都有要求。远程真机服务降低了硬件门槛,却会把稀缺资源转化为排队时间、运营成本和平台治理压力。提供轻量 smoke test、分层评测和透明的资源配额,会让更多团队真正用起来。
7. 榜单需要更清晰地区分“模型能力”和“系统能力”
VLA、WAM、Agent、单任务模型和 Preview 系统可能拥有完全不同的数据、工具调用和推理预算。官网已经把 Agent 单列,这是正确方向;后续还可以增加参数量、训练数据规模、推理时延、显存、是否开源和平均能耗等列,让排名从“谁分高”升级为性能—成本前沿。
RoboDojo 的真正意义
RoboDojo 最值得关注的地方,不是它又增加了多少个任务,而是它试图定义一种新的机器人评测公共设施:
- 对研究者,它提供可复现的能力诊断,而不只是一个总成功率;
- 对模型开发者,它用 XPolicyLab 降低跨环境部署成本;
- 对没有真机条件的团队,它提供远程物理评测入口;
- 对整个社区,它用隐藏验证、开放工件和视频审查提高排行榜可信度。
目前的结果也传达了一个清晰信号:机器人模型已经能在很多任务上“开始做对”,但离稳定完成仍很远。Score 与 Success Rate 之间的落差、仿真与真机排序的不一致,以及精密接触和错误恢复上的失败,都说明下一阶段的竞争不会只是扩大模型和数据,还会集中在长期记忆、阶段规划、接触反馈、闭环纠错、安全控制和跨本体适配上。
如果 RoboDojo 能持续维护版本、扩大本体范围、补充安全与效率指标,并证明仿真诊断与真实部署之间的定量关系,它可能成为通用机器人操控领域的重要“公共考场”。而在那之前,最合理的使用方式不是把排行榜第一名简单等同于“最强机器人模型”,而是把它当成一张高分辨率的能力体检表:看模型在哪里进步、在哪里失败,以及下一轮研究应该把资源投向哪里。
图片来源说明:图 1—6 来自 RoboDojo 官方网站或论文,并在各图图注中标明来源;图 7 为本站依据各项目论文与官方协议制作的定性比较图。外部图片的版权归原权利人所有。
参考资料
- RoboDojo 论文:A Unified Sim-and-Real Benchmark for Comprehensive Evaluation of Generalist Robot Manipulation Policies
- RoboDojo 官方网站
- RoboDojo 在线排行榜
- RoboDojo 榜单评测与反作弊协议
- RoboDojo 官方代码仓库
- XPolicyLab 官方代码仓库
- RLBench
- CALVIN
- LIBERO
- SimplerEnv
- RoboTwin 2.0
数据说明:本文榜单数据核验于 2026 年 10 月 10 日,官网数据更新时间为 2026 年 10 月 9 日(UTC+8)。在线榜单持续更新,引用排名时建议保留日期,并以官网最新页面为准。
评论 (0)
登录 后参与讨论
加载评论中...